
这篇文章在讨论什么
Foundry Agent Service 的 agent optimizer 会评估提示型或托管型 agent 的表现,生成候选配置,在同一数据集和标准下排序,最后由开发者挑选要部署的版本。每次优化涉及两个模型:执行任务的 agent 模型,以及审阅评估结果并提出修改建议的反思模型。若评估使用 LLM 裁判,还会有第三个裁判模型。文章关心的问题是:反思模型该选哪个?
测试是怎么设计的
团队比较了五个反思模型,以 GPT-5 为参照。测试覆盖四类负载:设施工单分类、税务推理、零售政策决策和小学数学应用题。每个模型在每类负载上各跑三次,共 60 次。同一负载内只更换反思模型,数据集、评估器和候选上限保持一致。需要注意,优化目标只限于指令,agent 模型大多是 gpt-4o-mini。
主要发现
来源给出的核心结论有三点。
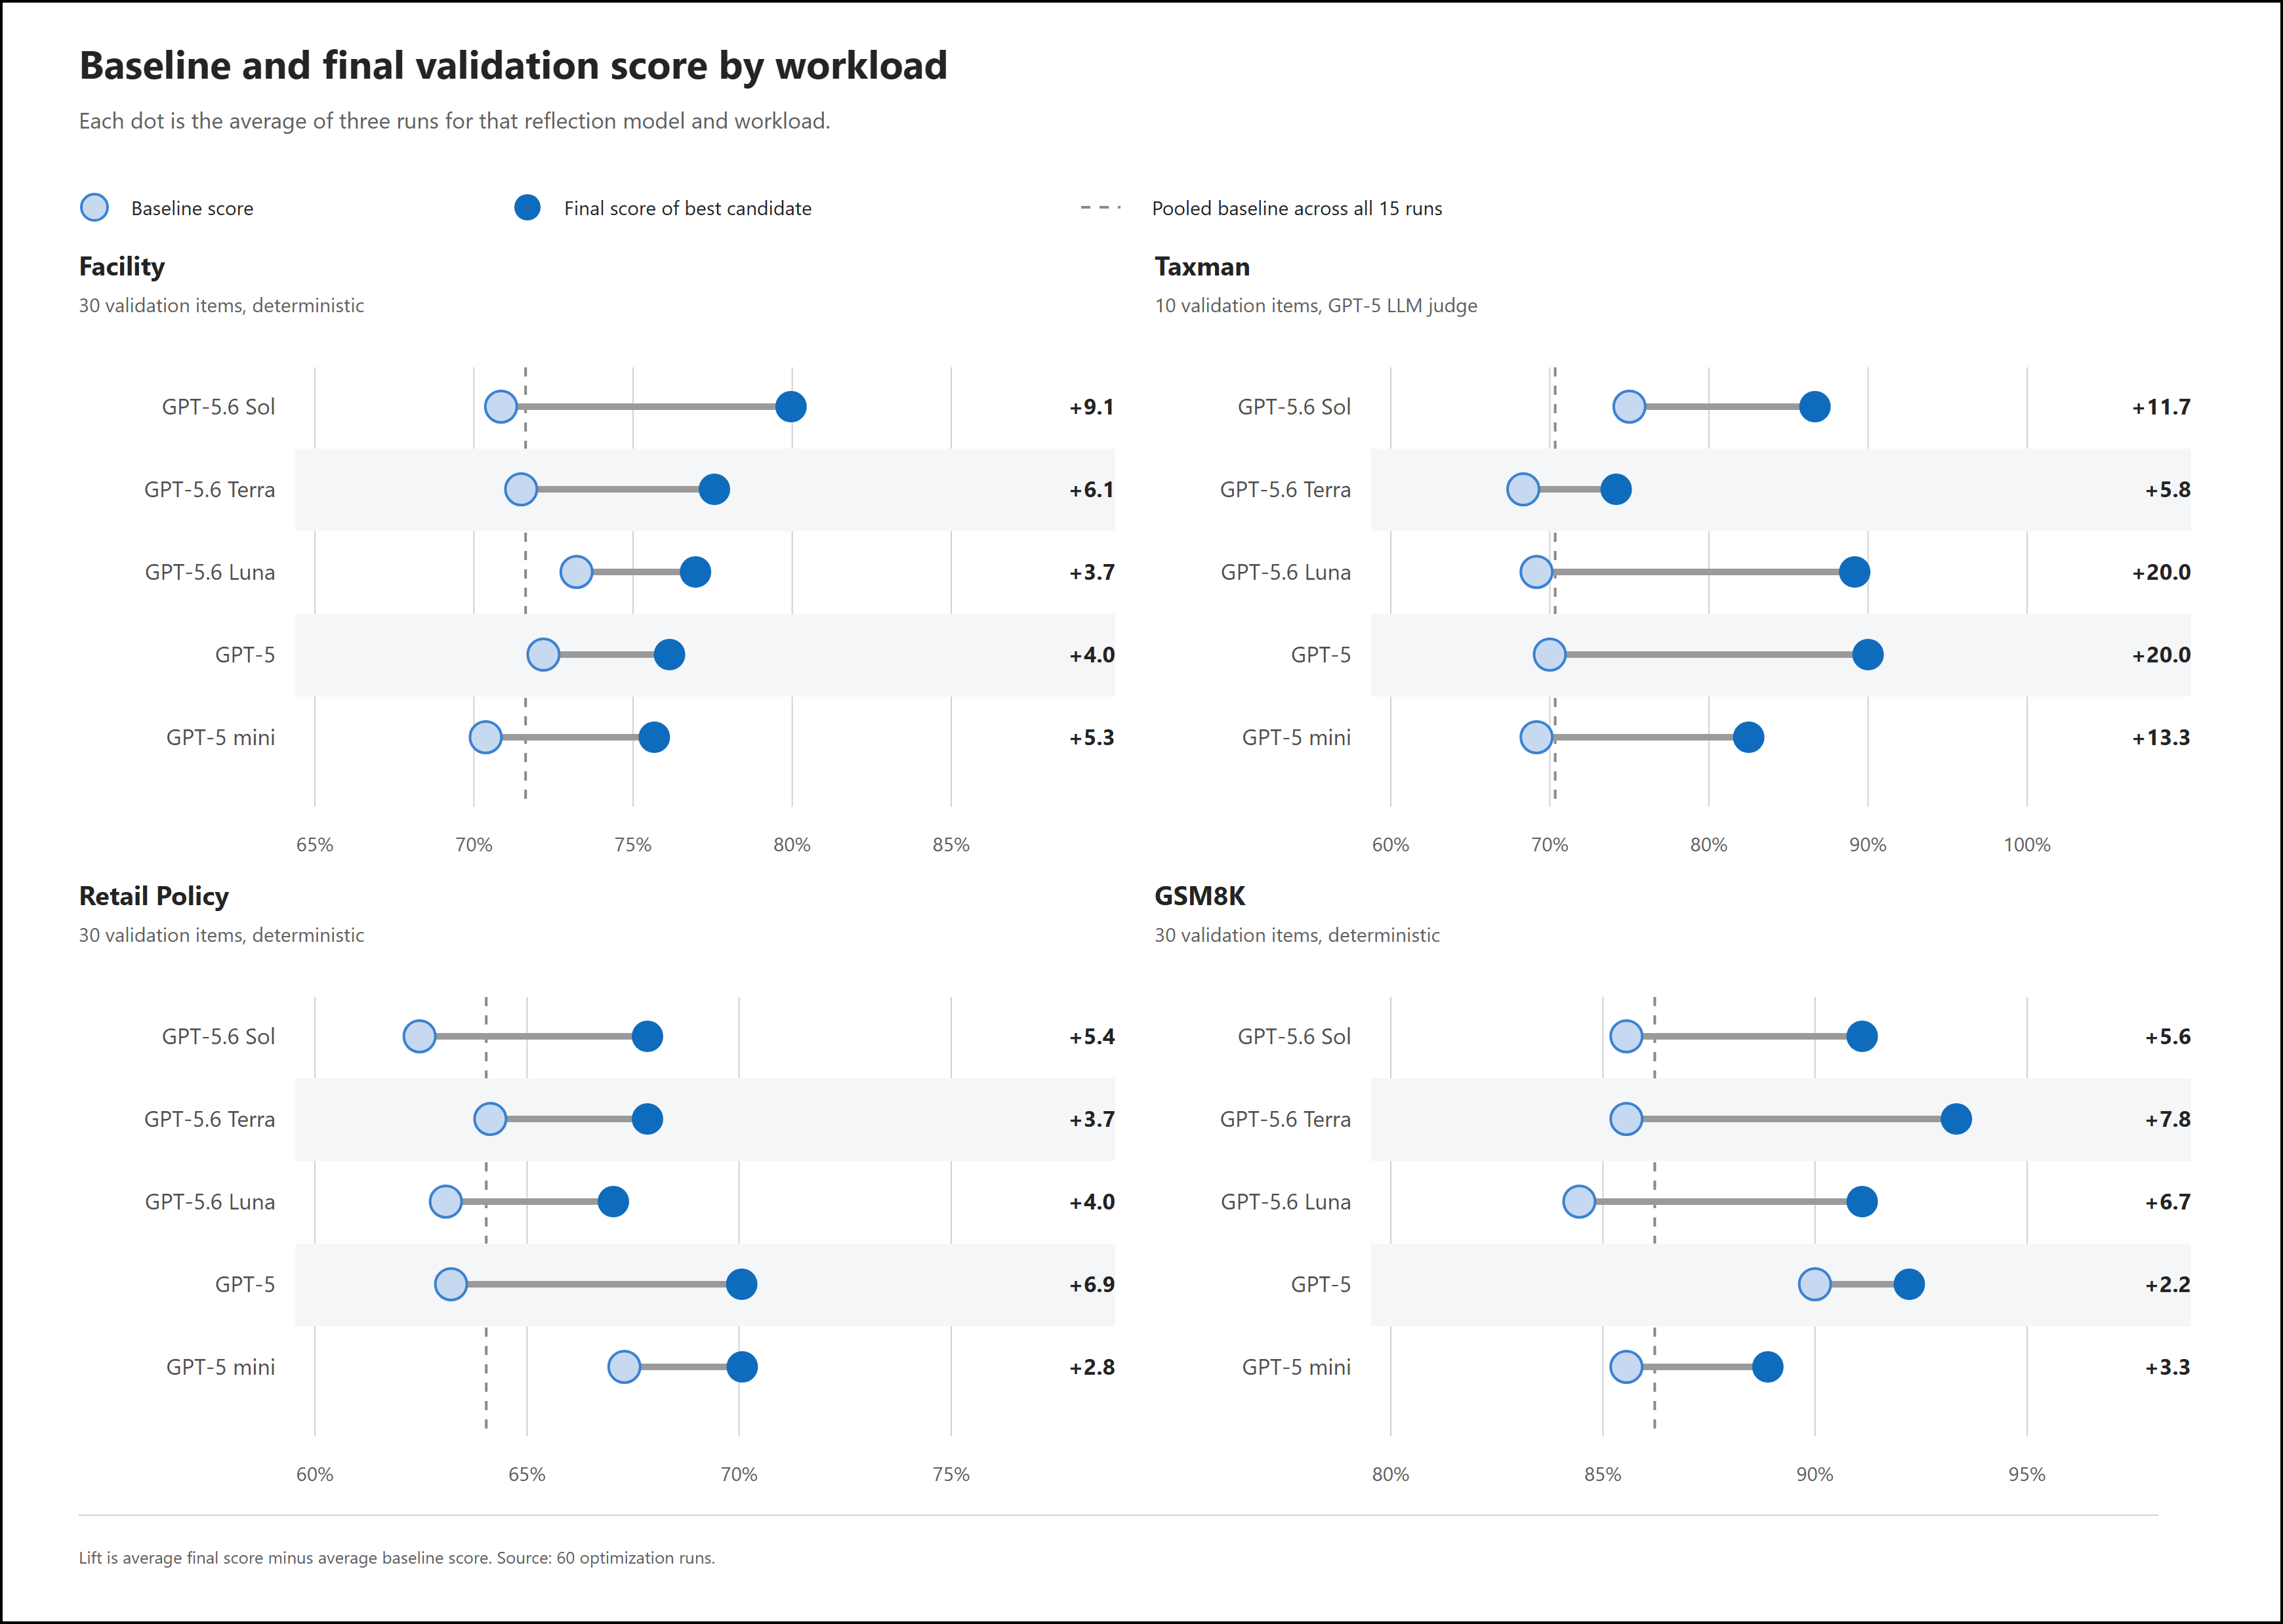
- 最优模型因负载而异。最终分数最高的模型在不同负载上并不相同,没有谁在四类任务上都领先。
- 稳定性方面,Sol 在全部 12 次运行中都提升了基线,Luna 为 10 次,GPT-5 为 9 次。
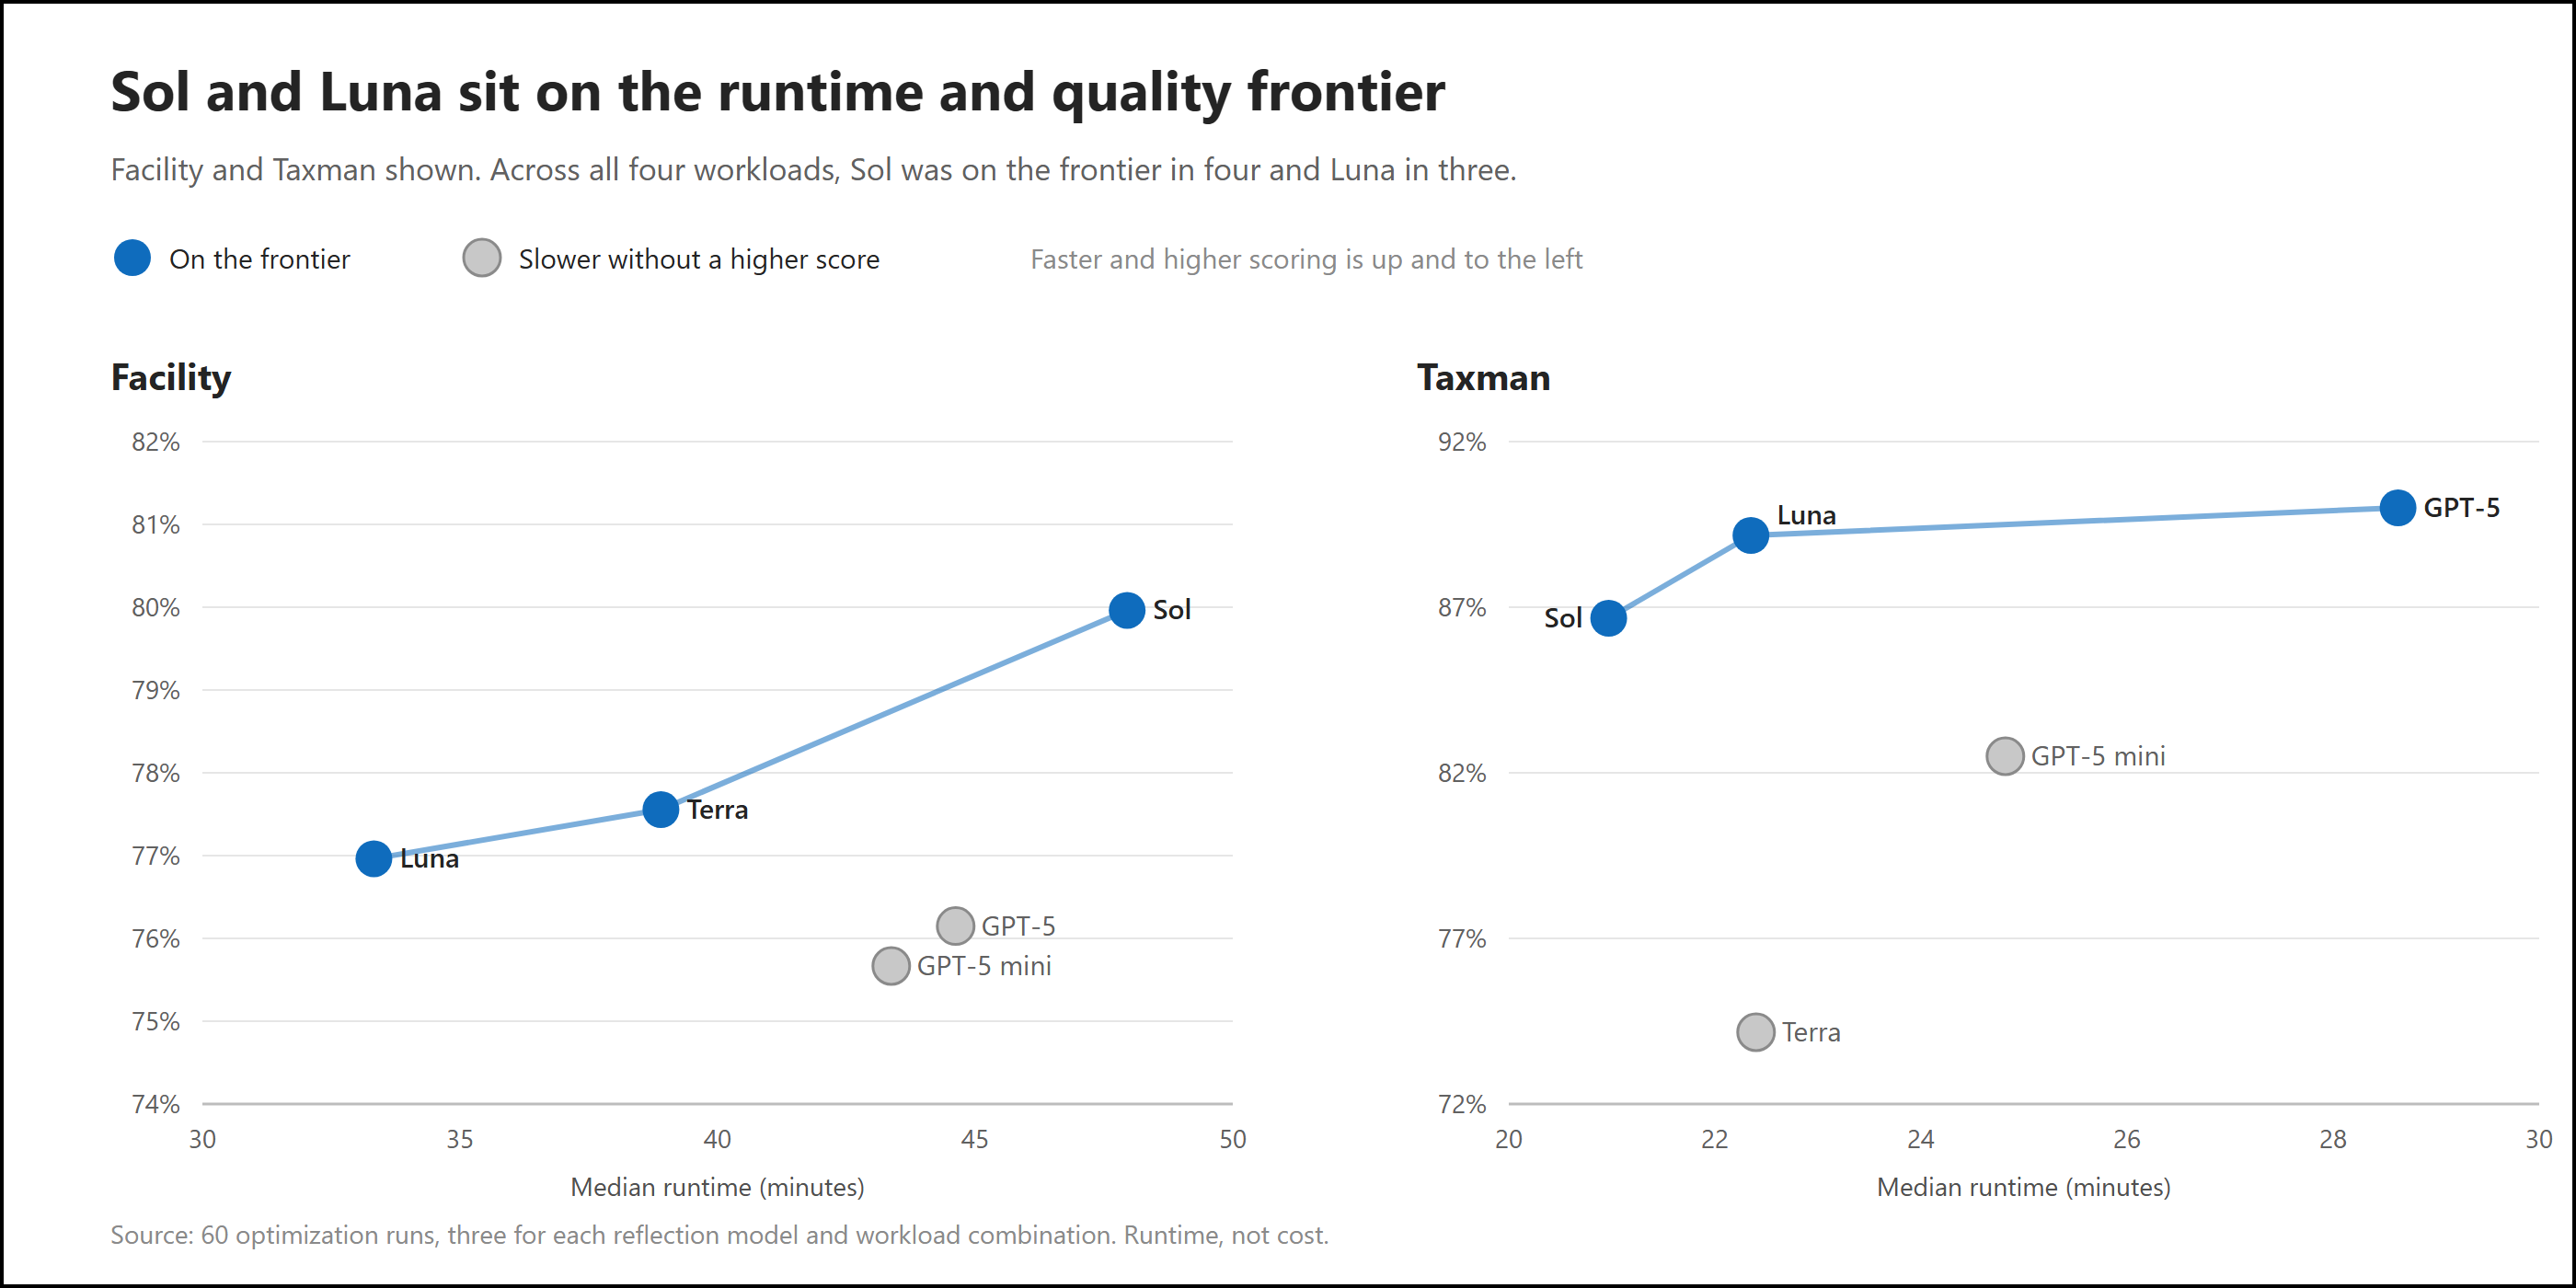
- 速度与质量方面,Sol 在四类负载上都处于运行时间与质量的前沿,Luna 在其中三类上处于前沿,并且总体最快。
文章的建议是:把 Luna 作为起点,追求分数时试 Sol,开发阶段 GPT-5 仍可作为参照,最终以自己的验证结果为准。
我的分析
以下是我的解读,不是来源的结论。
第一,对比只用了运行时间,没有算成本。各模型单价不同,如果团队按预算选型,排序可能改变。
第二,每组只有三次运行,验证集规模从 10 到 30 条不等。个别负载上分数差距很小,比如零售政策的最高分只差约 0.01 个百分点,不宜过度解读名次。
第三,这套做法对开发者更有价值的地方在流程:固定数据集和评估器,只换反思模型,再同时看最终分、提升幅度和运行时间。最终分决定该部署哪个 agent,提升幅度只说明优化帮了多少,因为它受起点高低影响。这套对照方法可以直接搬到自己的项目里。
适用场景与注意事项
如果你的 agent 属于分类、抽取、规则判断或数学推理一类,这些结果可以帮你缩小首轮试验的范围。文章也提醒,应使用有代表性的验证集和能衡量目标行为的评估器,并在提升或应用候选配置前人工审阅改动。
值得继续观察
- 换用更强的 agent 模型,或同时优化工具描述、技能与模型选择时,结论是否依然成立?
- 按成本而非运行时间排序,结果会怎样?
- 作者表示会随模型目录更新持续评估,后续指南可能调整。
来源
原文:Which Reflection Model Should Power your Agent Optimizer?(Microsoft Foundry Blog,2026-10-13):https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/which-reflection-model-should-power-your-agent-optimizer/4562671
- 作者:月明
- 链接:https://lunalight.top//article/azure-foundry-4562671
- 声明:本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。


